我亲手做并公开的工具及其过程
Off the Wall:把你过去的纠正原样再展示给编码智能体的插件
本文是韩文原文的简体中文翻译。如有出入,以韩文原文为准。
**模型不知道你的习惯,比如提交信息怎么写、日期怎么写。我让 Claude 做了 33 个这样的任务。没有 Off the Wall 时,Claude(Sonnet)遵守了习惯 2 次,有它时遵守了 20 次。**原因是你以前的纠正会原样再显示一遍。这些是我编出来的测试习惯,不是真实用户的记录。haiku 模型上是从 1 次到 17 次,重测时从 2 次到 25 次。详细测量见下面的”测试结果”。
Off the Wall 是 Claude Code 和 Codex 的插件。它把你给智能体的纠正保存在你自己的电脑上,之后你让它做类似的事时,会用你当时的原话再显示一遍。它是开源(MIT)的,不需要另外安装软件包,在 Node 18 及以上运行。
一句话
同一个文件夹里你以前做过的纠正,不加缩短,在智能体回答之前再显示一遍。
为什么做它
编码智能体不记得之前的对话。所以你总在重复”别问了,选一个""测试真的跑了吗?”。把纠正压成一行规则,当时的情况就丢了,比如你要求运行哪个测试、说过哪个文件不能动。原话里还留着这些内容。
和别的工具有什么不同
- 显示你说过的原话,不是概括。
- 只用同一个工作文件夹的记录。不会拿其他项目的纠正,也不会用最近的条目凑数。子文件夹和 git worktree 算不同的项目。
- 不需要单独的 API 密钥。判断一条消息是不是纠正,用的是你已经在用的
claude或codex命令。判断时用到的那部分对话会发给你所用的模型公司。 - 不会拖慢回答。判断在一旁单独进行,你发出的请求不会等它。
- 记录保存在你的电脑(
~/.otw)上,不会有数据发给作者。 - 会检查来源。插件自动发的消息不会被存成你的纠正,没有来源或文件夹的旧记录只保留、不使用。设置文件有错时,功能保持关闭。
它能做什么
**1. 再显示以前的纠正。**每次发请求时,它从同一文件夹的已存纠正里挑出最多 6 条,这些纠正当初针对的请求要和新请求看起来相似,每条截取 200 个字符,加到智能体读到的内容里。它不会在你的屏幕上显示成卡片,只传给智能体。还会加一句话,说明这不是新指令,也不是许可。
举个例子(编造的案例):你保存了”不要只跑 lint 就说测试通过。运行结账集成测试,并给我看真实的退出码。“之后你说”用结账集成测试验证支付处理器的改动。“智能体会原样收到那条纠正。
可以用 otw explain 预览会附上什么。下面是在虚构仓库里实际运行的输出(0.52 是匹配的接近程度):
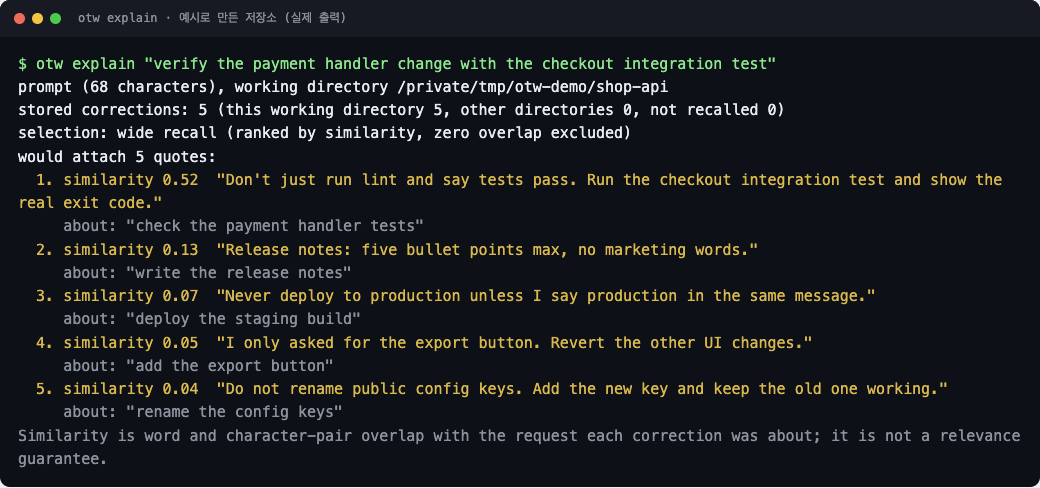
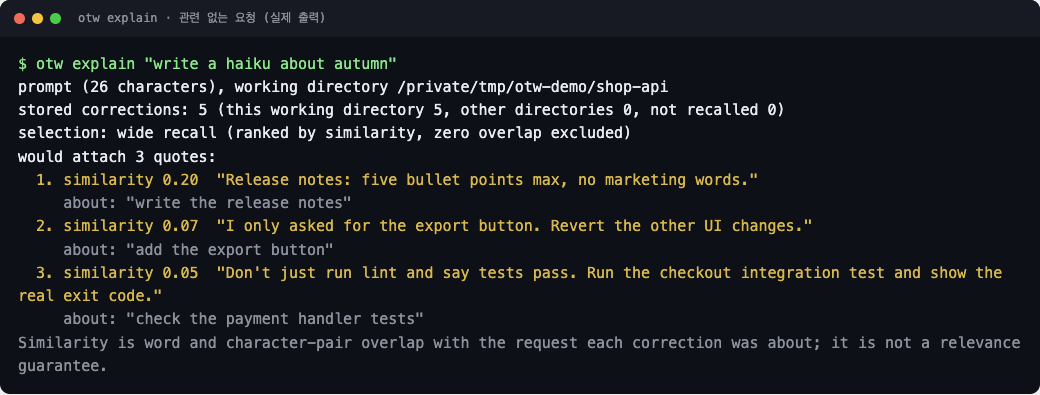
下面 0.04、0.05 的也会一起附上。这是现在的设计,不是 bug。即使是”写一首关于秋天的俳句”这种无关请求,也会附上 3 条。这是这个插件最大的弱点,所以我先摆出来:
**2. 自动保存你的纠正。**由一个模型单独判断你的下一条消息是不是在纠正上一条回答,是的话就保存。默认开启,用 capture: false 关闭。
3. 显示你最常纠正什么。otw report 让模型从你电脑上已有的 Claude Code 和 Codex 对话里,挑出你想纠正智能体做法的回复,按类别列出,并附上你的原话。加上 --seed 就用这个结果直接开始保存。分类由模型完成,可能有误。
4. 显示状态。otw status 显示已保存的纠正数、钩子最近运行的时间和你在 Codex 里允许的项目数。还没有保存时会直接说明。它也会列出使用的 Codex 模型,以及因为描述里没有写明等级而不使用的模型。
5. 预览会显示什么。otw explain "<句子>" 显示这句话会附上哪些纠正,以及每条匹配得有多接近。它不调用模型,也不改变任何东西。这个命令只在最新源码(main)里,不在 0.3.1 发布版中。
6. 删除你的记录。otw forget --all --yes 删除已保存的纠正、会话记录和日志。otw forget --project --yes 只删除当前文件夹的记录。不带 --yes 时只显示将被删除的内容。它不能删除你的 Claude Code、Codex 对话,也不能删除已经发给模型公司的内容。
**7. 建议辅助智能体用哪个模型。**它告诉智能体:搜索、转换用小模型,实现、评审用中等模型,找根因、做设计用大模型;没有指定模型的辅助调用会被退回一次。它不强制模型,也不保证降低成本。
它做不到的,以及需要知道的
- 不能保证减少失误。在测试用的习惯上有效,在真实使用记录上我没有测量过。
- 它不理解含义。按重叠的词和字母对来挑选,所以选出的纠正不一定和当前请求有关。
- 无关的请求也会被附上。从 0.3.0 起,20 个字符以上的请求都会附上最多 6 条(约 300 个 token)。更短的输入沿用之前的规则(相近程度 0.18 以上)。要关闭,在设置里加入
"recallWide": false。 - 可能把不是纠正的话存下来,也可能漏掉真正的纠正。在一个人的对话上,保存的内容里 82% 是对的,真正的纠正中找到了 72%。
- 删除命令从 0.3.1 起有了,但它不能删除 Claude Code、Codex 的对话,也不能删除模型公司那里留下的副本。
- 在 Codex 里要在
/hooks中允许一次钩子。允许之前什么都不会发生。 - 我没有在直接使用 Claude Code 的界面上确认过。我在没有界面的情况下自动运行,确认过一次保存和再显示。
- 当前版本是 0.3.1 预发布版,不是正式版。
试用
在 Claude Code 里:
/plugin install off-the-wall --marketplace toranalytics/off-the-wall在 Codex 里:
codex plugin marketplace add toranalytics/off-the-wall
codex plugin add off-the-wall@off-the-wall
在 Codex 里要打开一次 /hooks 并允许钩子。想在安装前看输出是什么样,可以用仓库里的虚构对话记录运行 report。
git clone https://github.com/toranalytics/off-the-wall && cd off-the-wall
node bin/otw.mjs report --host claude --claude-dir examples/claude-history --days 0想先在浏览器里看,有一个再显示纠正的演示(界面是韩文)。无需安装或登录,所有输入都是编造的案例。源码在 GitHub。
测试结果
全部用编造的记录测量。我在没有界面的情况下自动运行 Claude Code 2.1.311,用了一个小模型(haiku)和一个较大的模型(Sonnet)。这些数字只适用于这些测试,并不说明真实使用中的效果。
**模型会遵循个人习惯吗?**我把模型无从得知的 11 个习惯(提交格式、使用的工具、语气、日期格式等)做成任务,每个运行 3 次。任务和评分器由我之外的另一个模型编写,评分自动进行,计划在运行前就定好了。
| 条件 | 第一次(haiku) | 修复评分器错误后重测(haiku) | Sonnet |
|---|---|---|---|
| 没有 Off the Wall | 1/33 | 2/33 | 2/33 |
| 原默认(窄检索) | 9/33 | 14/33 | |
| 宽检索(0.3.0 起默认) | 17/33 | 25/33 | 20/33 |
- 正确的纠正显示出来时,模型遵循的频率高得多。找不到时则没有变化。
- 较大的模型(Sonnet)上也一样:按任务看更好的 7 个、更差的 0 个(很难说是偶然,p = 0.016)。没有 Off the Wall 时,较大的模型同样没有遵循这些习惯。
- 评分器是在看到结果之后修复的,所以重测不是独立的复现。数字变高一部分来自修复,一部分来自每次运行的波动,我无法把两者分开。
- 11 个任务中有 4 个,两个模型即使看到了纠正也没有遵循。直接塞入 150 条规则总体得分更高,但历史变长之后这种做法就行不通。
- Opus 和 Codex 的模型我没有测量过。
**附到无关的请求上有害吗?**我用 14 个与习惯无关的任务各运行 3 次:没有 Off the Wall 40/42,宽检索 41/42。通过率没有下降,输出 token 增加约 9%。短于 20 个字符的输入的保护措施,我没有用模型测试过。
**所有想改进它的尝试都没有采用。**为了减少无关请求上的引用,我试过加词的条件:在 150 条记录上 6 条变成了 2 条,但在 240 条记录上仍约为 5.5 条。嵌入模型几乎去掉了所有引用,但也漏掉了相关的。在每条纠正旁边加上原始请求没有收益(33 次中 19 次,不加是 20 次)。合并同一条纠正的重复,效果很小。记录在仓库的 docs 里。
**早期重放的 39 个请求。**我把一个人的 39 个真实请求只以文字重放。6 条纠正加上”预测这个人会提出什么异议”这句话,比什么都不加多出 25 胜 11 平 3 负。与随机规则直接对比的 17 胜 14 平 8 负,不是确定优势的证据。纠正和预测句是一起测试的,我也没有用当前的挑选方式重做。
**在真实程序里的确认。**在 Codex 0.162.1 上,我确认过一次安装、允许钩子、保存纠正以及下一次请求时再显示。在 Claude Code 2.1.311 上,我自动运行确认过一次保存以及在新会话里再显示。同一次测试的第三个请求中,模型有一次连续 6 分钟输出异常冗长的内容(8 次重测中没有出现)。
**代码测试。**239 个测试在 Node 18、20、22、26 上通过,全部使用假输入和假命令。CI 在 Windows、Linux、macOS 的 Node 18、20、22 上运行。
计划、脚本、数据以及独立评审中发现的弱点,都在仓库 docs 中。如果出现了无关的纠正,或缺了需要的纠正,请通过 issue 告诉我。不必附上原文、代码或公司名称。