我亲手做并公开的工具及其过程
我为改进 Claude Code 插件试了五种办法,没有一个达到我自己定的标准
本文是韩文原文的简体中文翻译。如有出入,以韩文原文为准。
Off the Wall 是 Claude Code 和 Codex 的插件。它保存你给智能体的纠正,之后你让它做类似的事时,会用你当时的原话再显示一遍。这篇文章写的是没做成的事,因为我从那里学到的更多。
先说管用的部分
模型不知道你怎么写提交信息、怎么写日期。我编了 11 个这样的习惯,做成任务,每格 3 次,每个条件跑 33 次,全部无界面自动运行。
- Claude Sonnet 没有插件时 33 次中遵守习惯 2 次,有插件时 20 次。
- haiku 第一次测试从 1 次到 17 次,重测时从 2 次到 25 次。
这些是我编的习惯,不是真实用户的记录。评分器的错误是在看到结果之后修复的,所以重测也不是独立的复现。Opus 和 Codex 的模型我没有测量过。测试设计见通俗说明文章。
我想解决的问题
这个插件也会把引用附到无关的请求上。在与已存纠正毫无关系的 8 个请求里,平均附上了 1.8 条。我最初写的是”没有相似的就什么都不附”,这是不对的,我已经公开更正。现在的样子如下,这是在虚构仓库里对”写俳句”请求实际运行 otw explain 的输出:
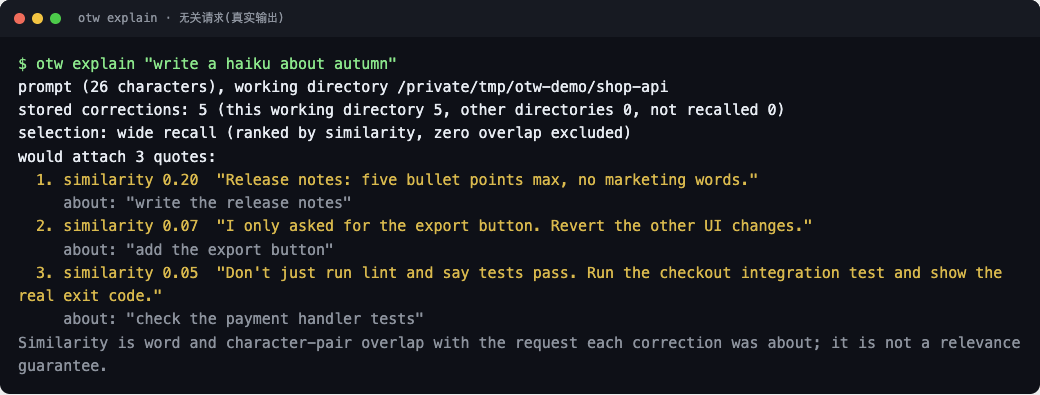
我想在保留有用引用的同时减少这种噪声。运行之前,我先把计划和达标线写进文件,再一个一个试。先说结论:五个都没有通过。
尝试 1. 加词语条件
只在共有 2 个词,或有 1 个稀有词重合时才附上。在有 150 条纠正的库里,无关引用从 6.0 条降到 2.0 条,看起来很不错。但在习惯重复的 240 条库里,是从 6.0 条到 5.5 条,几乎没变。只在一个库里管用的条件没有保留价值,放弃。
尝试 2. 针对短输入的 6 种变体
为了减少附到短输入上的引用,我做了 6 种变体。没有一个达标,保留原有的保护措施(短输入沿用旧规则)。
尝试 3. 嵌入模型
为了看看按含义挑选行不行,我试了一个小型本地嵌入模型(all-MiniLM-L6-v2)。一个设置大幅减少了噪声,但在单独留出的案例上漏掉了太多有用的引用。另外 3 个设置在同一标准上也被淘汰。
尝试 4. 在每条纠正旁边同时显示原始请求
我查看了在纠正旁边同时显示”当时我让它做什么”是否能让模型更好地遵循。只引用 20/33,引用加请求 19/33。没有收益,没有加入。
尝试 5. 把同一条纠正的重复合并
这是来自维基式记忆的想法:把重复合并成一条。18/40 对 20/40,提升 11%,而我的标准是 25%。否决。
除了结果之外学到的
- 在两个实验里,测试脚本把选择截断在 3 条,默认值是 6 条。我发现后记录下来,原来的数字保持不变。
- 有一个任务的评分器是错的,我事后重新评分。原来的表格保留,旁边写上更正。
- 通过我自己做的测试,并不等于对真实用户有帮助。真正的测试是你自己的纠正会不会积累下来,并在合适的时候回来。这方面的证据我还没有。
代码、计划、数据以及所有失败的测试记录,都在仓库 docs 里。如果你的会话里出现了无关的引用,或缺少需要的引用,请通过 issue 告诉我。不必发送原文。