我亲手做并公开的工具及其过程
Off the Wall:过去的纠正在新请求之前重新出现的那一刻
本文是韩文原文的简体中文翻译。如有出入,以韩文原文为准。
通俗地说,Off the Wall 是一个插件,在智能体回答之前,把我自己以前的纠正不加缩短地再显示一遍。我让 Claude 做了 33 个关于模型无从得知的习惯的任务:没有插件时遵守了 2 次,有插件时遵守了 20 次(Claude Sonnet,我编出来的测试习惯)。它能做什么、不能做什么,见通俗说明文章。本文是在那之前写的、更详细的测量记录。
更新记录。2026-10-29:在更大的模型(Sonnet)上也看到了同样的效果,删除已存纠正的
otw forget已随 0.3.1 发布。2026-10-28:第一次测量了对模型无从得知的个人偏好的效果(下面第 7 节)。2026-10-27:输入边界修复已随 0.2.0 发布,并增加了在真实 Codex 宿主上运行一次的记录。2026-10-23:我把旧实验显示的内容和公开插件实际证明的内容分开写了。最新的数字和局限见通俗说明文章。
纠正编码智能体时,重要的不只是一条”下次做好”的规则。你纠正了什么、在哪个请求里、怎么纠正的,这些在下一个任务之前也得还在。
Off the Wall 是一个早期插件,把保存的过去纠正原文,作为下一个请求的上下文引用给 Claude Code 和 Codex。它不是保证更好回答或更低成本的工具。
演示无需安装或登录。所有输入都是编出来的案例,展示公开钩子真正返回的上下文和空库的差别。它不是把更好的模型回答做成的前后对比。
1. 原文回来的那一刻
下面不是从个人对话里拿来的,是为演示编的例子。
不要只跑 lint 就说”测试通过”。运行结账集成测试,并给我看真实的退出码。
之后我发一个新请求:“用结账集成测试验证支付处理器的改动。“不是笼统的”好好验证”,而是我要求的是哪个测试、什么证据,用我自己的话回到上下文里。
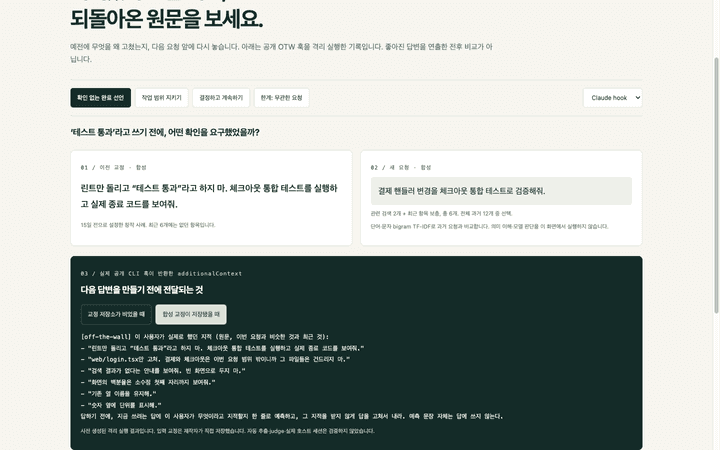
这是在合成输入上隔离运行的画面。我没有运行模型的下一次回答。别的任务的范围纠正也会混进来,这是第 4 节要说的局限。
演示里有保持任务范围的例子、我把选择权交给智能体所以不该再问的例子,还有无关请求也会收到最近纠正的局限例子。三个核心例子的纠正都比最近 6 条更旧。
2. 我实际检查了什么
我不加修改地运行了公开 OTW 0.1.1 的固定提交 07fe3d3d4f4accc153eb0684f506e0d3c206fdcc。
- 4 个合成请求 × 空库/已存库 × Claude/Codex 钩子模式,共 16 次命令行钩子运行。
- 存入的纠正和请求是我手工做的测试数据。我没有验证自动判定或从过去记录中提取。
- 我检查了相关且较新的纠正会被选中并进入
additionalContext,以及带有未来时间的纠正会被排除。 - 没有用到个人记录、模型提供方,也没有真实的 Claude Code 或 Codex 会话。
被回忆、模型遵循、真实任务成功、用户少纠正,这是不同的阶段。这次复现只确认了第一个。
2-1. 在真实 Codex 上运行一次(10 月 27 日新增)
上面的复现是不带宿主、只运行钩子。所以我在 macOS 的真实 Codex(codex-cli 0.162.1)上,用隔离的主目录和合成提示把插件 0.2.0 运行了一次。我确认了插件安装、钩子信任、一轮里保存纠正、下一轮里该纠正以开发者消息注入,以及对自带示例记录运行 otw report(20 条回答中分类了 9 条)。记录在仓库 docs 里。
- 钩子在被信任之前不会运行。只安装的话,什么都悄悄不发生。要在
/hooks里信任,从 0.2.1 起otw status会显示最近的钩子活动和已信任的项目数。 - 这是在一台电脑上运行一次。我没有查看模型是否遵循了被回忆的纠正。
- 我没能以交互方式运行 Claude Code。一开始没有登录的 Claude Code,所以做不了。后来在 Claude Code 2.1.311 的无头模式下用插件 0.2.1 确认过一次保存纠正和在新会话里回忆。同一次测试的第三轮中,模型有一次连续 6 分钟输出异常冗长的内容(8 次重测没有复现),交互使用我没有确认。记录在仓库 docs 里。
3. 现在的公开版本做什么
首次发布时,它先挑出最多 3 条保存的纠正(对应的过去请求在字符串特征上与新请求相似),再用最近的条目补足到最多 6 条。从 0.3.0 起 recallWide 默认开启:20 个字符以上的请求会按相似程度附上最多 6 条纠正,完全没有重合的则不附。检索是基于词和字符 bigram 的 TF-IDF,所以我不声称它理解含义或能准确判断适用范围。
开启判定功能后,会由单独的进程审阅上一条回答和新消息,保存纠正候选。report 是对已有对话里的纠正做分类的可选诊断功能。也有模型选择建议,但我不把它说成自动优化或一般意义上的节省成本。
被引用的块不是聊天窗口里的卡片,而是交给模型的额外上下文。本文的演示是用来查看这个隐藏输入的单独检查画面。
4. 只保留原文是不够的
演示里的支付测试请求,也选中了另一个任务的一次性范围纠正”只改登录文件”。对于一个无关的关于火星的问题,最近的 6 条纠正也进来了。
关键的那句话进来了,不代表整个选择就是恰当的。我得分清原文里的”这次请求”指的是不是过去的任务,以及它是不是现在还该保持的偏好。我还没有测过模型是否因此真的做错了。
接下来我想检查的是:区分长期偏好和一次性任务指令,显示原始请求、项目和适用范围这些来源,以及处理无关的最近条目。这不代表它已经是公开功能。
我还发现了一个输入边界问题:用户角色下插件自动发送的消息,可能被当成人的纠正来分类。加入来源标记和按工作目录回忆的修复已随 0.2.0 发布。即便如此,我也不能保证它能完全过滤自动输入。我以前在社交媒体上发过的个人记录统计(几千条里最多的纠正次数、比例等)可能被这个问题混淆,所以我撤回了,重新确认之前不再使用。
5. 旧实验说明了什么
以前我报告过一个探索性实验:把一个人记录里挑出的 39 个请求只以文字重放,不用工具,由模型评分。6 条引用加上”预测这个人会提出什么异议”这句话的条件,对比什么都不附,统计为 25 胜 11 平 3 负。
但与随机规则直接对比的 17 胜 14 平 8 负,不是确定优势的证据(报告的双侧检验 p 约为 0.11)。引用格式和预测指令没有分开,所以不能说是原文本身的因果效果。
我在保存的运行日志里确认了总数和条件,但没有独立重跑原始的逐案输出。需要运行东西或核对事实的工作,大多无法用这种文字重放来评估。当前公开版本的真实任务成功率、长期保持和平均成本节省,都需要另外验证。
6. 数据与成本
保存的结果和会话状态默认放在本地 ~/.otw。但判定和个人报告分析,会通过我用的 Claude 或 Codex 命令行把对话摘录发给该模型提供方。“任何数据都不会离开电脑”这种说法是不对的。即使不需要单独的 API 密钥,调用提供方也可能消耗套餐额度、用量和费用。
我还测了一次回忆块让提示增加多少(Codex 0.162.1,合成纠正 6 条,codex exec resume 的第二轮)。关闭回忆时输入为 13,743 个 token,只开回忆为 14,028(+285),只开子智能体模型选择建议为 14,364(+621),两者都开为 14,781(+1,038)。每个条件只测一次,仅供参考。我还看到恢复的会话里模型选择建议被注入了两次,这个重复已在 0.2.2 修复(增加了恢复测试)。这只测了提示大小,不代表回答质量或节省成本。记录在测量备忘里。判定在分离的进程里运行,但我不保证整体使用体验没有延迟。删除存储和提供方一侧的数据处理是两回事。
7. 10 月 28 日的测量:模型会遵循它原本不知道的习惯吗
之前的测试挑的是模型本来就不会犯的错(跑测试、做到底),所以开不开回忆都是满分。OTW 该有用的地方不在那里,而在模型无从得知的个人习惯:提交格式、使用的包工具、语气、日期格式。
所以我把这样的偏好 11 个做成任务,每个跑 3 次,共 33 次。任务和评分器由我之外的另一个模型编写,评分全部自动。计划在运行前就定好了。
| 条件 | 遵守习惯的次数 |
|---|---|
| 没有 OTW | 1/33 |
| OTW 原默认(窄检索) | 9/33 |
OTW 宽检索(recallWide,0.3.0 起默认) |
17/33 |
- 我换了一个库重做,出现了大小相近的差距(16/33 对 8/33,17/33 对 9/33)。
- 原因在检索。对的那条过去纠正进入引用时,模型遵循得多得多,找不到时则没有变化。宽检索更常找到。
- 局限也很明确。11 个任务中有 1 个,“一句话”的格式要求太严,即使显示了引用模型也没有遵循。另一个 0/3 的任务,后来发现是评分器的错误(把用代码块包起来的回答判为不通过),重新读记录发现看到纠正的 6 次里有 5 次遵循了(事后重新统计,所以表里的数字保持原值,它低估了真实效果)。在模型本来就不会犯的错上我没有找到好处(16 个任务中的 14 个),直接塞入 150 条规则总体得分更高。但历史变长之后,把所有规则塞进去的做法就行不通。
- 修复评分器错误后,我用同一个库和任务又跑了一次(99 次):没有回忆 2/33,原默认 14/33,宽检索 25/33。方向一样。数字变高一部分来自修复,一部分来自每次运行的波动,所以我没有改上面的表。记录在仓库 docs 里。
- 我还不知道的:真实用户的长记录、haiku 和 Sonnet 之外的模型(Opus、Codex 模型)、交互使用、长期效果。(10 月 29 日我用 Sonnet 跑了同样的任务:没有回忆 2/33,当前默认 20/33。)这些纠正是模型写的合成记录。宽检索的代价是给每个请求附上最多 6 条引用(约 300 个 token),所以我还另外检查了它在与偏好无关的 14 个任务上是否碍事(没有 OTW 40/42,宽检索 41/42,没有看到干扰;输出 token 增加约 9%)。因此从 0.3.0 起默认开启,短于 20 个字符的输入沿用之前的规则(这个保护措施本身我没有测试)。要关闭,在设置里加入
"recallWide": false。
实验记录、计划、脚本以及独立评审中发现的弱点,都在仓库 docs 里。
8. 试用之前
希望你先看合成回忆演示。分析你自己的记录和保存回忆是另外的选择。输入边界修复已经公开,但还没有在真实使用中充分验证,所以本文暂时不建议对个人记录运行 report --seed。
安装和设置请看当前 README。Codex 需要在 /hooks 里信任钩子这一步,不做的话钩子会悄悄不运行(可以用 otw status 查看)。在 Windows 上,要把 CI 里测试和钩子运行通过,与真实宿主会话成功区分开。
我最需要的反馈不只是成功的经历。我想知道无关的纠正是否回来了、需要的纠正是否缺了、回忆之后智能体是否仍然犯了同样的错。可以通过 issue 告诉我,不必附上原文、代码或公司名称。我不要求提交个人记录或报告原文。